基于系統聚類分析的網絡入侵檢測研究
隨著互聯網技術的迅猛發展,網絡攻擊手段日益復雜多樣,傳統的基于特征匹配的入侵檢測方法已難以應對未知攻擊和變種攻擊。網絡入侵檢測作為網絡安全防御體系中的重要環節,正面臨新的挑戰。在此背景下,無監督學習方法受到越來越多研究者的關注。其中,聚類分析因其無需先驗標簽即可發現數據內在結構的能力,被廣泛應用于網絡入侵檢測領域。本文圍繞基于系統聚類分析的網絡入侵檢測方法展開探討,分析其原理、實現流程及其在實際應用中的優勢與局限。
一、網絡入侵檢測概述
網絡入侵檢測系統(Intrusion Detection System, IDS)通過采集網絡流量或主機日志數據,識別異常行為或已知攻擊模式。按照檢測方式可分為誤用檢測和異常檢測兩大類。誤用檢測依賴已知攻擊特征庫,對未知攻擊的檢測能力有限;異常檢測則通過建立正常行為模型,將偏離模型的行為判定為異常。聚類分析屬于典型的異常檢測方法之一,能夠在無標簽條件下對數據樣本進行分組,從而實現入侵行為的發現。
二、系統聚類分析的基本原理
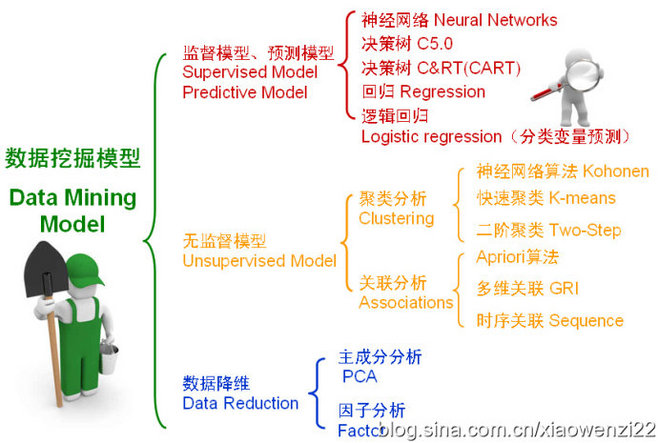
系統聚類(Hierarchical Clustering)是一種經典的聚類方法,其核心思想是通過逐步合并或分裂樣本,構建具有層次結構的聚類樹(樹狀圖)。根據合并策略的不同,系統聚類可分為單鏈、全鏈、平均鏈以及Ward方法等。其中,Ward方法以最小化簇內方差為目標,在實際應用較為廣泛。系統聚類不依賴預先指定的簇數量,能夠通過樹狀圖和距離閾值來確定聚類結果,適合探索性數據分析。
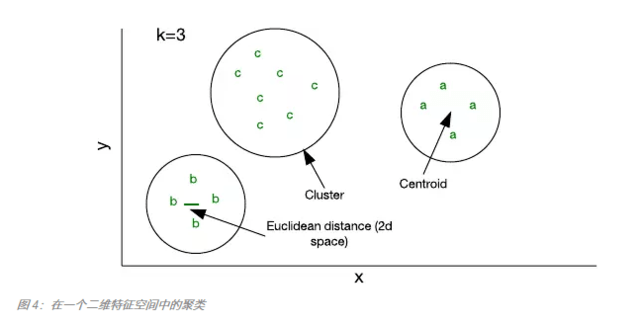
在網絡入侵檢測中,通常將網絡連接記錄表示為特征向量,例如連接持續時間、協議類型、傳輸字節數、登錄失敗次數等。不同攻擊類型(如拒絕服務攻擊、端口掃描、遠程未授權訪問等)在特征空間中往往呈現不同的分布模式。系統聚類能夠將這些樣本按相似性進行分組,使同簇樣本具有較高相似度,而不同簇之間差異較大,進而輔助識別異常簇。
三、基于系統聚類的入侵檢測流程
基于系統聚類分析的網絡入侵檢測一般包括以下步驟:
數據預處理。對原始網絡流量數據進行清洗、缺失值處理和歸一化,消除量綱差異對距離計算的影響。
特征選擇與降維。從大量特征中篩選與入侵行為相關性較高的特征,必要時采用主成分分析等方法降低維度,以提高聚類效率和準確性。
距離度量與聚類。選擇合適距離度量(如歐氏距離、曼哈頓距離)和聚類策略,構建聚類樹并對樣本進行劃分。
異常判定。根據簇的大小、密度以及簇內樣本與正常行為模型的偏離程度,將遠離主要數據分布的小簇標記為異常或攻擊。
結果評估。利用有標簽數據集(如KDD Cup 99、NSL-KDD等)對檢測結果進行評估,采用檢測率、誤報率、F1值等指標衡量方法性能。
四、系統聚類在網絡入侵檢測中的優勢與局限
系統聚類分析方法具有以下優勢:第一,無需標簽數據,適用于標注成本高昂的場景;第二,能夠發現未知攻擊,彌補傳統誤用檢測的不足;第三,層次結構可視化有助于分析人員理解攻擊行為的分布規律。
系統聚類也存在明顯局限。一方面,其時間復雜度較高,處理大規模網絡流量數據時計算開銷大;另一方面,聚類結果對距離度量和預處理方式較為敏感,參數選擇不當可能導致誤報率升高。網絡流量中存在大量噪聲和類別不平衡問題,也會影響聚類效果。
五、改進方向與發展趨勢
為提升系統聚類在網絡入侵檢測中的適用性,研究者提出了多種改進思路。一是將系統聚類與分割聚類(如K-means、DBSCAN)結合,先降采樣再聚類,以降低計算復雜度;二是引入半監督學習,在少量標簽引導下優化聚類邊界;三是結合深度學習特征提取方法,自動學習更具判別性的流量表示;四是采用增量式聚類,支持在線流量數據的實時檢測。
隨著網絡攻擊不斷演化,基于系統聚類分析的入侵檢測方法仍然具有重要的研究價值。未來的研究可在提高檢測精度、降低誤報率以及增強實時性等方面持續深入,為構建更加智能和自適應的網絡安全防御體系提供支撐。
如若轉載,請注明出處:http://www.ichezheng.cn/product/63.html
更新時間:2026-11-09 22:07:40