應用視角下的聚類網絡分析 核心指標與評估體系
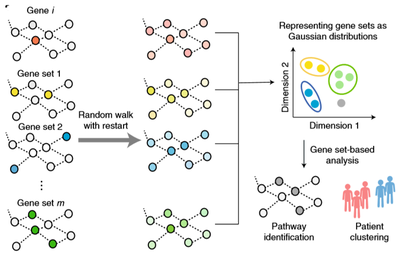
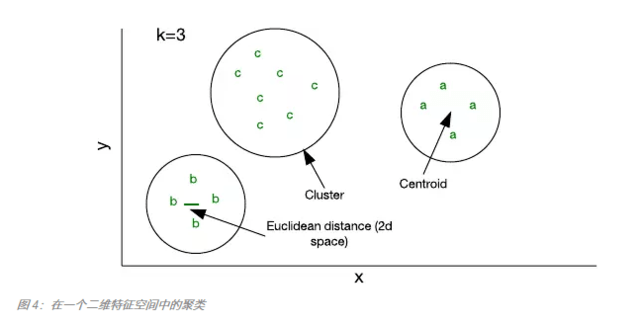
聚類網絡分析旨在從復雜網絡中識別出節點集群(即“社區”),使得集群內部連接緊密,集群之間連接稀疏。這種分析在社交網絡、生物網絡、信息網絡等領域具有廣泛應用。如何評價一個聚類網絡的質量,需要綜合多種指標。本文將從骨架但不限于以下維度,系統梳理聚類網絡分析中常用的評價指標與評估策略。\n\n一、聚類結構的基本指標\n1. 模塊度(Modularity):最經典的社區發現評價指標,衡量社區內部邊數是否顯著高于隨機期望。值域[-0.5,1),越大表示社區結構越明顯。\n2. 社區內部密度與外部密度:分別刻畫社區內聚程度和社區間分離程度,常以內部邊數/可能邊數與外部邊數/可能邊數表示。\n3. 社區規模與數量:描述聚類的基本拓撲屬性,常用于比較不同算法輸出的粒度。\n4. 覆蓋度(Coverage):網絡中每個節點至少歸屬一個社區的比例,以及每個社區包含的節點占總節點的比例,用于評估是否遺漏重要節點或過度碎片化。\n\n二、網絡聚類質量的外部與內部評估\n當網絡帶有真實標簽時(如已知社區劃分),可使用外部指標:\n- 標準化互信息(NMI):衡量聚類結果與真實劃分之間的信息重疊,值域[0,1],值越高表示匹配越好。\n- 調整蘭德指數(ARI):校正隨機一致性的成對節點分類一致性,值域[-1,1],1表示完美匹配,0表示隨機水平。\n- F1-score(成對或基于標簽):用于社區級或全局層面精度與召回率的調和平均。\n\n當沒有真實標簽時,需要內部指標和相對評價:\n- 輪廓系數(Silhouette Coefficient):結合距離度量計算節點與自身社區及其他社區的分離性,可用于比較不同聚類劃分。\n- Calinski-Harabasz指數:基于類間方差與類內方差的比值,值越大越優。\n- 基于啟發式的穩定性指標:例如對網絡進行擾動(加邊/刪邊、重采樣)后比較聚類結果的一致性(如Jaccard相似度或信息論一致性)。\n\n三、從網絡結構角度考慮的擴展指標\n1. 介數中心性與聚類邊界:跨社區的邊往往具有高介數,識別并修剪這些邊有助于改善聚類;可分析邊界節點占比、割邊比例。\n2. 參與系數與模塊內中心性:參與系數度量一個節點連接不同社區的程度,模塊內中心性刻畫節點在自身社區中的核心程度,常用在重疊社區分析中。\n3. 鏈路預測兼容性:評價聚類對缺失鏈接的預測能力,如AUC、Precision-Recall曲線,可驗證社區結構是否有助于生成鏈接。\n4. 動態與多層網絡的擴展指標:在時序網絡中考慮社區演化(如穩定性、時間平滑性);在多層網絡中衡量跨層社區一致性與重疊性,如多層模塊度。\n\n四、過擬合與穩定性的相關分析\n經常被忽略但實際非常重要的還有:\n- 泛化能力評估:使用交叉驗證或節點/邊抽樣的方法,檢驗聚類劃分在未見子圖上的魯棒性。\n- 參數敏感性分析:社區發現算法通常包含分辨率參數,如Louvain中的分辨率ξ,需要掃描參數以獲得穩定且最優的粒度。\n- 隨機共識評價:采用多次隨機初始化下的共現矩陣與方陣一致性(如CDF曲線)評價算法輸出的穩定性。\n\n五、綜合評估框架的建議\n實踐當中不應只依賴于某一個指標進行評估。推薦采用“主指標+輔指標”的多維框架:以模塊度或NMI等1-2個主指標為核心,同時引入穩定性、效率等方面的因子。可以用雷達圖直觀比對多個算法的指標取值。當在大規模網絡上評價時,還可額外納入計算復雜度、時間/內存占用費用;在動態網絡中時則加入時間聚合數據不平衡的作用。應以問題任務為導向,綜合考慮不同指標的科學解釋。“主觀目標+客觀結果加權+穩定性擾動策略”可以提高聚類質量的復用性。\n\n本文展示了聚類網絡分析中豐富多維的評估指標體系。但在不同度量與實踐中需要注意源數據特征:不能只看某個聚類數量簇系數高其準確性最高就會出現碎片化結果的局極端狀態以及盲目假設所有評測符合邊緣權重分布關系等現象經常擾亂指標使用判斷的相關因素對于“好的劃分常有多維度支撐具備語義可解釋性且符合先驗知識策略導向可穩定復仿的新版本策略動態自適應不斷打磨型系統工具是大需求下關于局部領域的關鍵決策補說明需要對應表述有關評估應該各重避輕謹時頻用批而概念統計同步。相對謹慎量隨概念時間場景標定函數參數模型數據調用架構耦合體系水平一并列出優選出理性范疇可托付執行的成套保障方案,這也是促使聚類網絡有效性邁向人工智能實用化的具有深化性質的基準工作。'
}
如若轉載,請注明出處:http://www.ichezheng.cn/product/53.html
更新時間:2026-11-09 10:16:27